CodeSucker 实用评估:软件著作权源程序文档能不能放心交给工具整理
从文件选择、清洗规则、分页校验、离线边界和安装包风险,评估 CodeSucker 是否适合纳入软著材料准备流程。
准备软件著作权源程序材料,最麻烦的往往不是写代码,而是把一个不断变化的仓库冻结成一份可检查的文档。文件要选哪些,顺序怎么安排,空行和注释是否清理,前后 30 页从哪里开始和结束,最后还要检查页眉、行数和署名。CodeSucker 把这件事拆成五个可回看的步骤,适合用作研发交付前的一道材料整理门。
先建立申报副本,别直接动工作目录
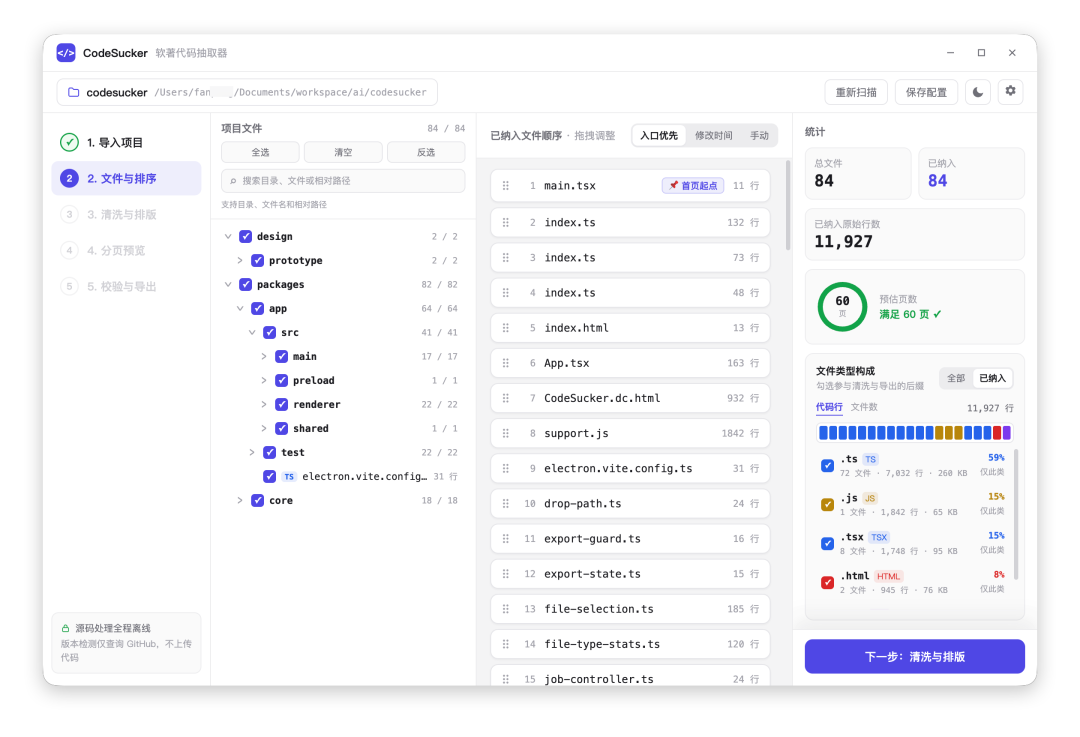
使用任何源码整理工具之前,建议从 Git 工作区复制一份申报副本,并记录提交版本、软件版本和申请主体。这样即便清洗规则不符合预期,也不会影响正在开发的主分支。CodeSucker 支持扫描目录、按文件类型查看构成、叠加项目排除规则和手动调整纳入文件;这些能力适合从一份混杂的工程目录里挑出能说明软件功能的源码。
文件顺序是可读性问题,也是证据边界问题
导出的材料不是代码备份,而是让审查者在有限页数里看懂软件结构。入口文件、核心业务模块、数据模型和关键界面逻辑通常比测试缓存、构建产物和第三方目录更有解释力。工具提供入口优先、修改时间和手动排序,但不要机械地按修改时间导出:最近改过的文件不一定最能代表软件。
对跨语言项目,还要注意顺序是否会把同一功能拆散。可以先按“启动入口—核心流程—持久化或接口—辅助模块”的逻辑组织,再用分页预览检查首尾是否完整。若项目有大量生成代码,应明确哪些是自行开发、哪些是自动生成或第三方来源,避免权属说明含混。
清洗规则应服务于审查,而不是服务于页数
项目支持删除空行和注释、统一缩进、折断超长行,并用状态机识别字符串与注释边界。对包含链接、正则和模板字符串的源码,这是比全局正则更稳妥的处理方式。与此同时,清洗必须保留可追溯性:任何删除、脱敏和截取都应该能回到原始提交进行核对。
不建议为了达到页数而删除所有注释。能解释模块边界、版权归属或关键算法的内容可能有实际价值;真正需要清理的是无意义的空白、重复生成内容和与软件无关的噪声。页数达标只是最低门槛,材料是否能对应到真实软件仍需要人工判断。
把校验前置,减少最后一轮返工
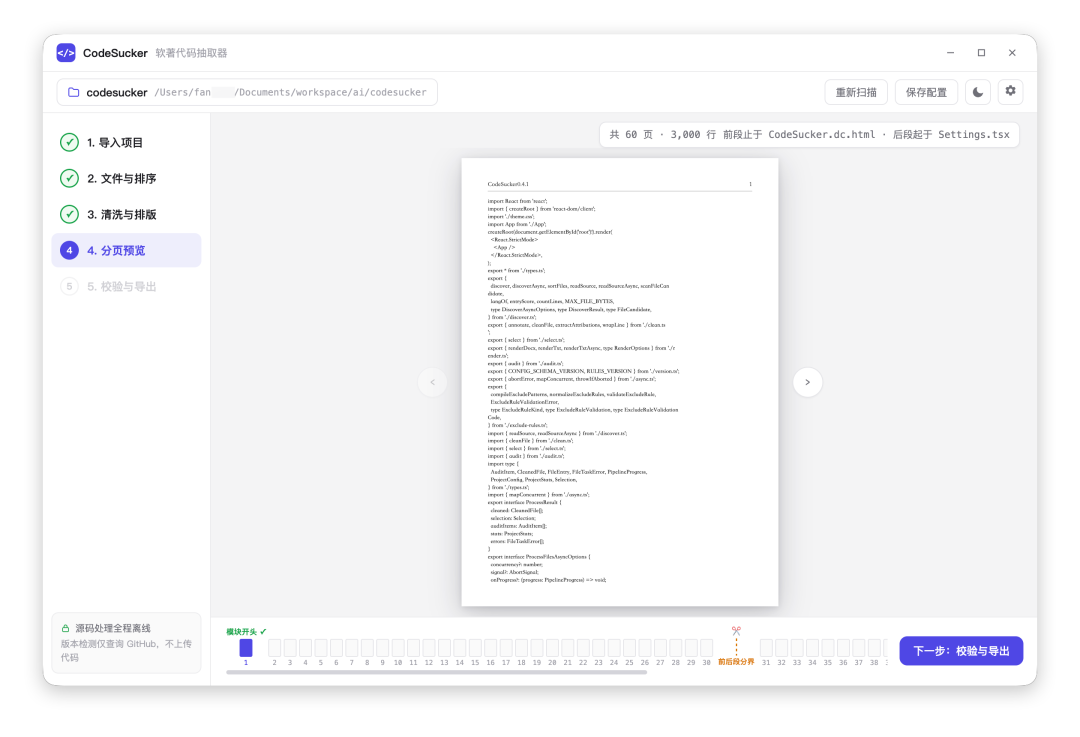
CodeSucker 的分页预览会显示总页数、代码行数以及前后段的来源,导出前还会检查每页行数、页眉中的软件名和版本号、末页占比,以及 @author 或 Copyright 署名冲突。按照项目 README,目标是生成前后各 30 页的 60 页材料;由于登记规则可能调整,报告通过后仍应以最新官方要求复核。
研发团队可以把这一步纳入发布清单:版本冻结后生成申报副本;负责人审核文件清单;工具跑一次清洗和校验;人工抽查 docx 的字体、页码、页眉与首尾内容;最后把校验报告和源码版本一并归档。这样,软著材料就不再是某个人临时加班完成的手工活。
安装包和法律边界
CodeSucker 当前公开版本为 v0.4.4,采用 Apache-2.0 许可证,提供 macOS 和 Windows 安装包。macOS 安装包尚未完成签名与公证,下载时应从 GitHub Release 获取并核对 SHA-256。工具可以帮助整理材料,但不提供法律意见,也不能保证某一份导出文件自动满足登记机构的全部要求。
结论
CodeSucker 的可取之处,是把“选代码、排顺序、清洗、分页、校验、导出”串成一个能重复执行的流程。对个人开发者,它减少一次性排版工作;对团队,它可以成为版本冻结后的材料检查环节。真正稳妥的做法不是按下导出就结束,而是把工具报告、原始提交、申请主体信息和最终 docx 放在同一条可追溯链路里。